
On rêve tous d’un petit côté magique au bureau : l’information qui apparaît quand on en a besoin. La réalité de beaucoup d’entreprises est moins féérique : des documents éparpillés, des versions multiples, des informations qu’il faut aller chercher à la main, souvent chez quelqu’un. Et un diagnostic presque toujours erroné : on croit manquer de temps, alors que c’est l’organisation des flux d’information qui ralentit tout. Voici comment centraliser, méthodiquement.
Le coût de l'information éparpillée
Le calcul mérite d’être fait une fois : quelques minutes pour retrouver une information, multipliées par le nombre de recherches quotidiennes, multipliées par le nombre de personnes. Sur une année, la chasse aux documents pèse des journées entières par collaborateur, invisibles parce que diluées.
S’y ajoutent des coûts moins comptables et plus graves : les erreurs de version (le devis envoyé n’était pas le bon), les décisions prises sur des données périmées, et les nouveaux arrivants qui mettent des mois à savoir où vivent les choses. L’information éparpillée ne fait pas que perdre du temps : elle fragilise ce qu’on décide avec.
Les symptômes qui ne trompent pas
Cinq signes révèlent une information malade, et chacun se reconnaîtra dans au moins deux.
Le fichier « présentation_finale_v3_DEF_vraiment », et ses cousins.
La pièce jointe d’un email qui est devenue, de fait, le document de référence : introuvable pour qui n’était pas en copie.
La même information saisie dans trois outils, avec trois orthographes.
Le « demande à Martine, elle sait où c’est » : la mémoire d’une personne devenue le moteur de recherche de l’entreprise.
Et le dossier personnel d’un collaborateur transformé, au fil des ans, en archive officielle que personne d’autre ne peut ouvrir.
Chaque symptôme raconte la même histoire : l’information existe, mais elle n’a pas d’adresse.
La source unique de vérité : par où commencer
Le principe fondateur tient en une règle : pour chaque type d’information, un seul endroit fait foi. Les coordonnées client vivent dans le CRM, point. Les documents contractuels vivent dans tel espace, point. Tout le reste peut y faire référence, jamais le dupliquer : un lien vers la source vaut toujours mieux qu’une copie qui vieillira dans son coin.
Inutile de tout traiter d’un coup : commencez par les trois types d’information les plus critiques pour votre activité, typiquement les données clients, les documents contractuels et les éléments projets. Pour chacun, désignez la source, migrez ce qui traîne ailleurs, et annoncez la règle. Le reste suivra, type par type, au rythme que l’activité permet.
Conventions et arborescence qui tiennent dans le temps
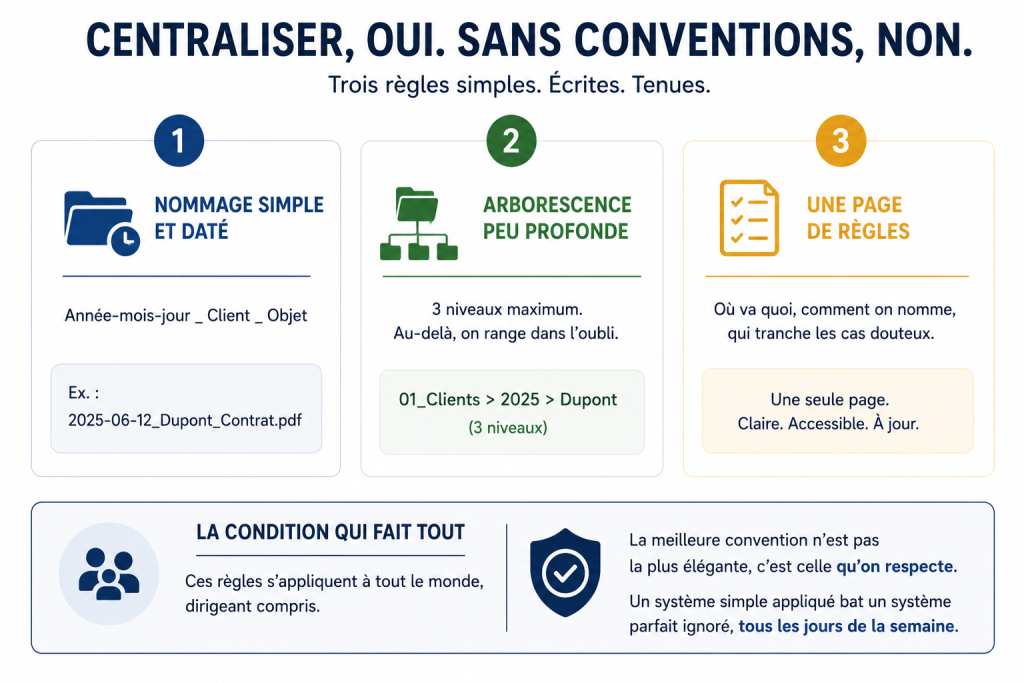
Une centralisation sans conventions redevient un fouillis, juste plus gros. Trois règles suffisent, à condition d’être écrites et tenues. Un nommage simple et daté : année-mois-jour, client, objet ; celui qui cherche en 2028 vous remerciera. Une arborescence peu profonde : trois niveaux maximum ; au-delà, on range dans l’oubli. Et une page de règles, une seule : où va quoi, comment on nomme, qui tranche les cas douteux.
La condition qui fait tout : ces règles s’appliquent à tout le monde, dirigeant compris. La meilleure convention n’est pas la plus élégante, c’est celle qu’on respecte. Un système simple appliqué bat un système parfait ignoré, tous les jours de la semaine.
Automatiser la collecte et le classement
Voici la partie qui change l’effort en habitude : l’entrée de l’information s’automatise remarquablement bien. Un cas de terrain le résume : la collecte des pièces jointes clients d’une équipe passait par trois canaux à surveiller, avec les oublis et le stress qui vont avec. Après automatisation, chaque document reçu est extrait, renommé selon les conventions et rangé dans le bon dossier, seul. Les recherches inutiles ont disparu, et la charge mentale avec : plus rien à surveiller, plus rien à penser.
Le principe se généralise : extraction des pièces jointes, renommage automatique, rangement à la bonne adresse, création des fiches correspondantes. Ce sont des automatisations simples et très rentables, précisément parce qu’elles transforment la discipline (fragile) en mécanique (constante). La centralisation tenue par la seule bonne volonté s’érode ; tenue par un workflow, elle tient.
Maintenir la centralisation dans le temps
Une information centralisée dérive sans entretien, comme tout le reste. Trois gestes suffisent à la garder saine. Une revue trimestrielle légère : trente minutes pour repérer les débordements (le nouveau dossier sauvage, la convention qui glisse) et les corriger avant qu’ils ne fassent école. L’intégration des nouveaux outils à la règle : tout logiciel qui arrive se connecte à la source unique, il n’en crée pas une seconde ; c’est le même réflexe que pour la stack logicielle dans son ensemble. Et l’onboarding qui enseigne les conventions dès le premier jour : les nouveaux arrivants appliquent ce qu’on leur montre, pas ce qu’on suppose.
Une information centralisée prépare l'arrivée de l'IA
Dernier bénéfice, et pas le moindre : tout ce qui précède est exactement le prérequis des usages d’IA qui comptent. Un assistant documentaire restitue la qualité de la base qu’on lui donne : branché sur une information centralisée, à jour et cohérente, il devient remarquablement utile ; branché sur l’éparpillement, il restitue l’éparpillement, poliment. Le chatbot interne qui répond depuis vos documents commence donc ici, dans les conventions et la source unique.
Autrement dit : centraliser rapporte aujourd’hui (le temps de recherche, les erreurs de version) et prépare demain. C’est le rare chantier qui paie deux fois.
Retrouver une information en secondes change une journée
La centralisation de l’information n’est ni un projet informatique ni une lubie d’organisation : c’est la fin d’une friction quotidienne que tout le monde subit en silence. Une source unique par type d’information, des conventions d’une page, l’entrée automatisée, un entretien léger : le chemin est court, et l’effet se sent dès les premières semaines.
Si vous voulez identifier par où commencer chez vous (quels flux d’information font le plus mal, dans quel ordre les traiter), c’est une question qu’un audit règle en une observation : on voit très vite où les documents se perdent.
Questions fréquentes
Pourquoi perd-on autant de temps à chercher l’information ?
Parce que l’information n’a pas d’adresse : versions multiples, documents de référence enfouis dans des emails, mêmes données saisies dans plusieurs outils, mémoire d’une personne en guise de moteur de recherche. Cumulée, cette chasse représente des journées entières par collaborateur et par an.
Par où commencer pour centraliser l’information ?
Par le principe de la source unique : pour chaque type d’information, un seul endroit fait foi, tout le reste y renvoie sans dupliquer. Commencez par les trois types les plus critiques (clients, contrats, projets), désignez la source, migrez, annoncez la règle, puis étendez type par type.
Quels outils choisir pour centraliser ?
Ceux que vous avez déjà, bien souvent : le problème est rarement l’outil, c’est l’absence de règle et de connexion. Définissez les conventions, désignez les sources, puis automatisez l’entrée (extraction, renommage, rangement) pour que la discipline devienne mécanique.
Comment maintenir la centralisation dans le temps ?
Trois gestes : une revue trimestrielle de trente minutes pour corriger les dérives, l’intégration de tout nouvel outil à la source unique plutôt qu’à côté, et un onboarding qui enseigne les conventions dès le premier jour. Sans entretien, toute centralisation redevient un fouillis.